产品与方案咨询
了解产品能力、应用方案与演示安排

加企业微信,直接沟通您的需求
了解产品能力、应用方案与演示安排
沟通部署、系统接入与使用中的问题
客户挑战
节点、网络、存储和平台服务彼此关联,局部异常可能影响作业执行,需要结合多个对象的运行信息判断问题。
GPU 型号、驱动与操作系统并存,监控对象和指标需要统一梳理。
网络质量、存储时延与节点负载相互影响,排查需要结合多方信息。
数据库、中间件和接口分别运行,平台健康信息缺少集中呈现。
告警来自不同工具,影响确认、通知和派单需要跨团队反复沟通。
方案架构
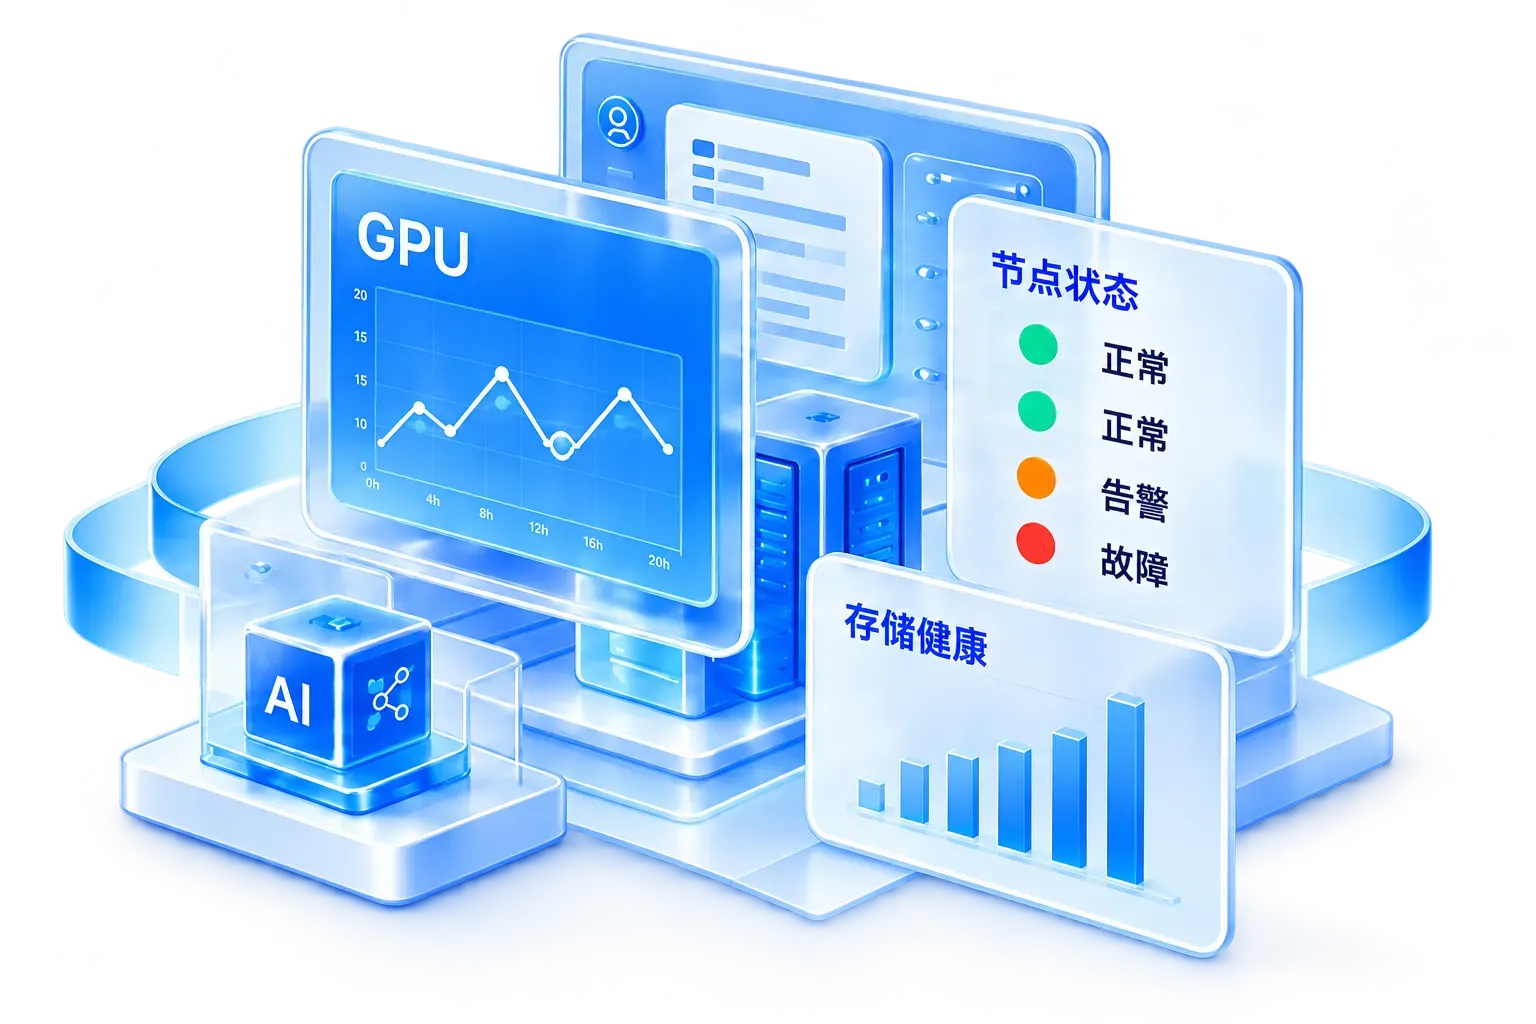
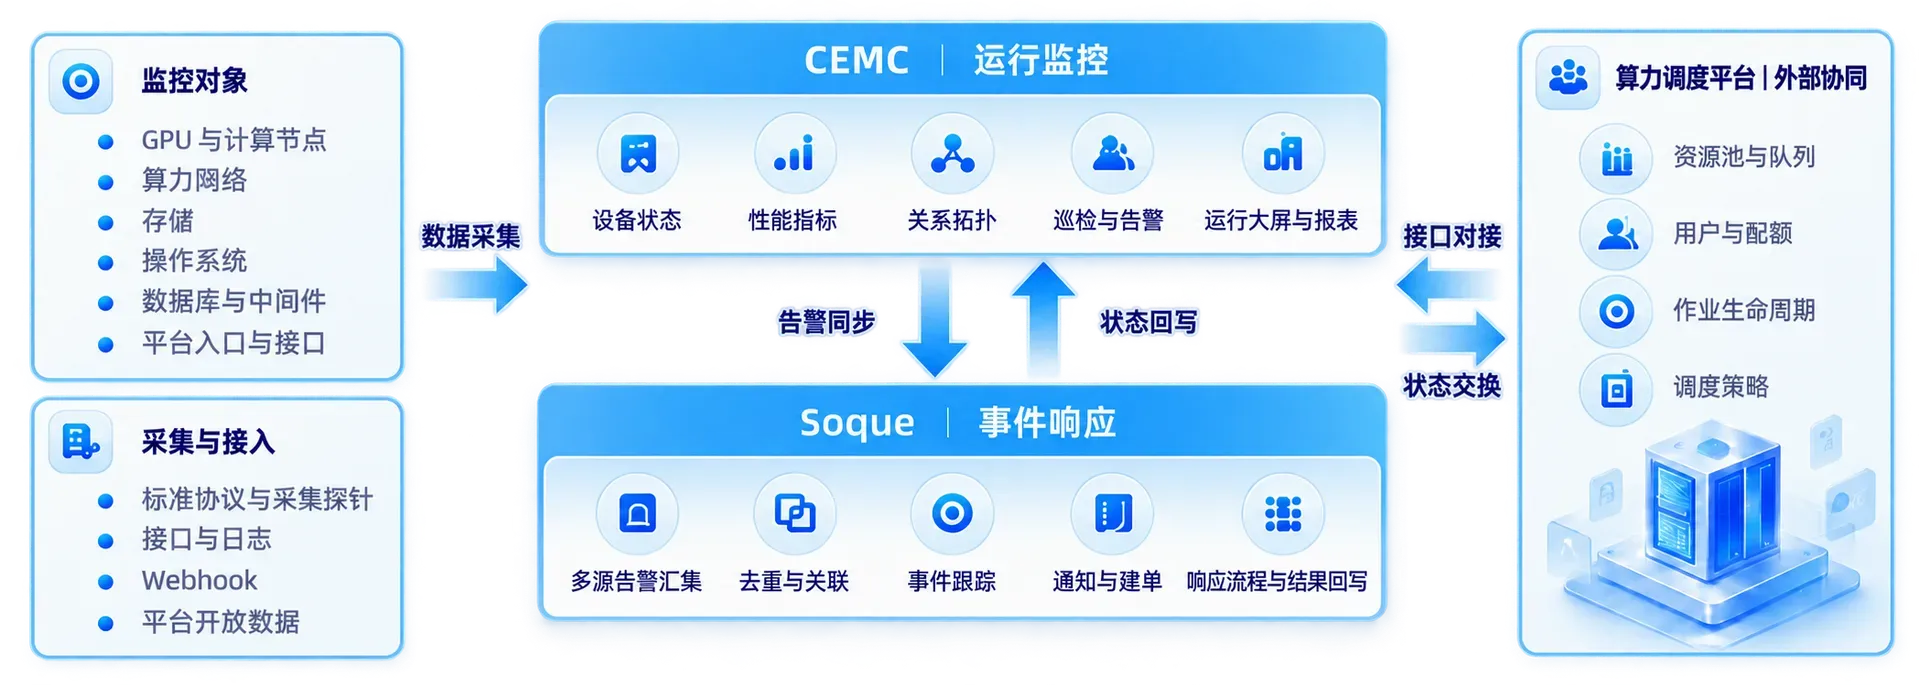
以 CEMC 汇集资源状态、性能与运行关系,通过 Soque 关联多源告警和处理动作,与算力调度平台交换健康与异常信息。
监控范围
按算力业务运行链路组织监控对象,集中查看设备状态、性能变化与关联风险。
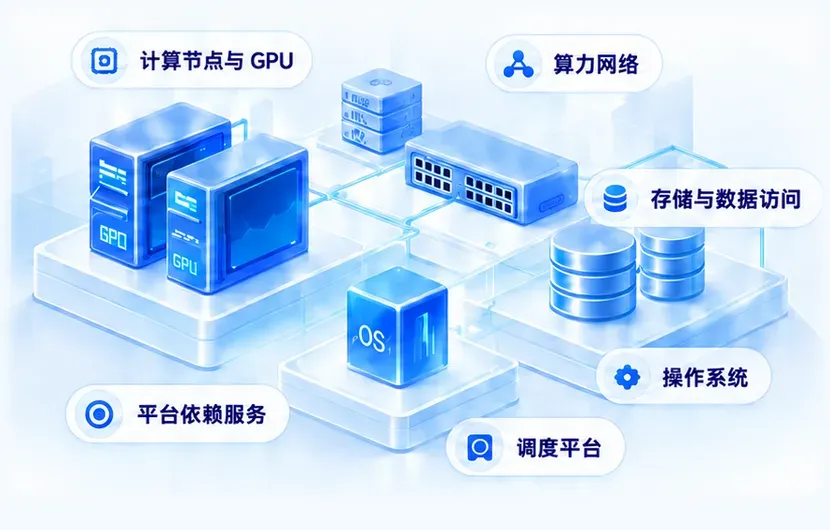

关注 GPU 利用率、显存、温度、功耗及节点硬件健康,结合操作系统资源状态查看运行变化。

关注设备与端口状态、链路流量、丢包及错误指标,结合拓扑查看异常位置和关联链路。

关注容量、读写性能、控制器与磁盘状态,识别存储空间和访问性能风险。

集中查看 CPU、内存、磁盘、负载、进程和端口,关联主机上的服务运行情况。

关注数据库、中间件的连接、线程、内存及服务状态,辅助定位平台运行问题。

通过接口、日志或 Webhook 接入组件与集群健康信息,按需关联作业状态摘要。
方案介绍
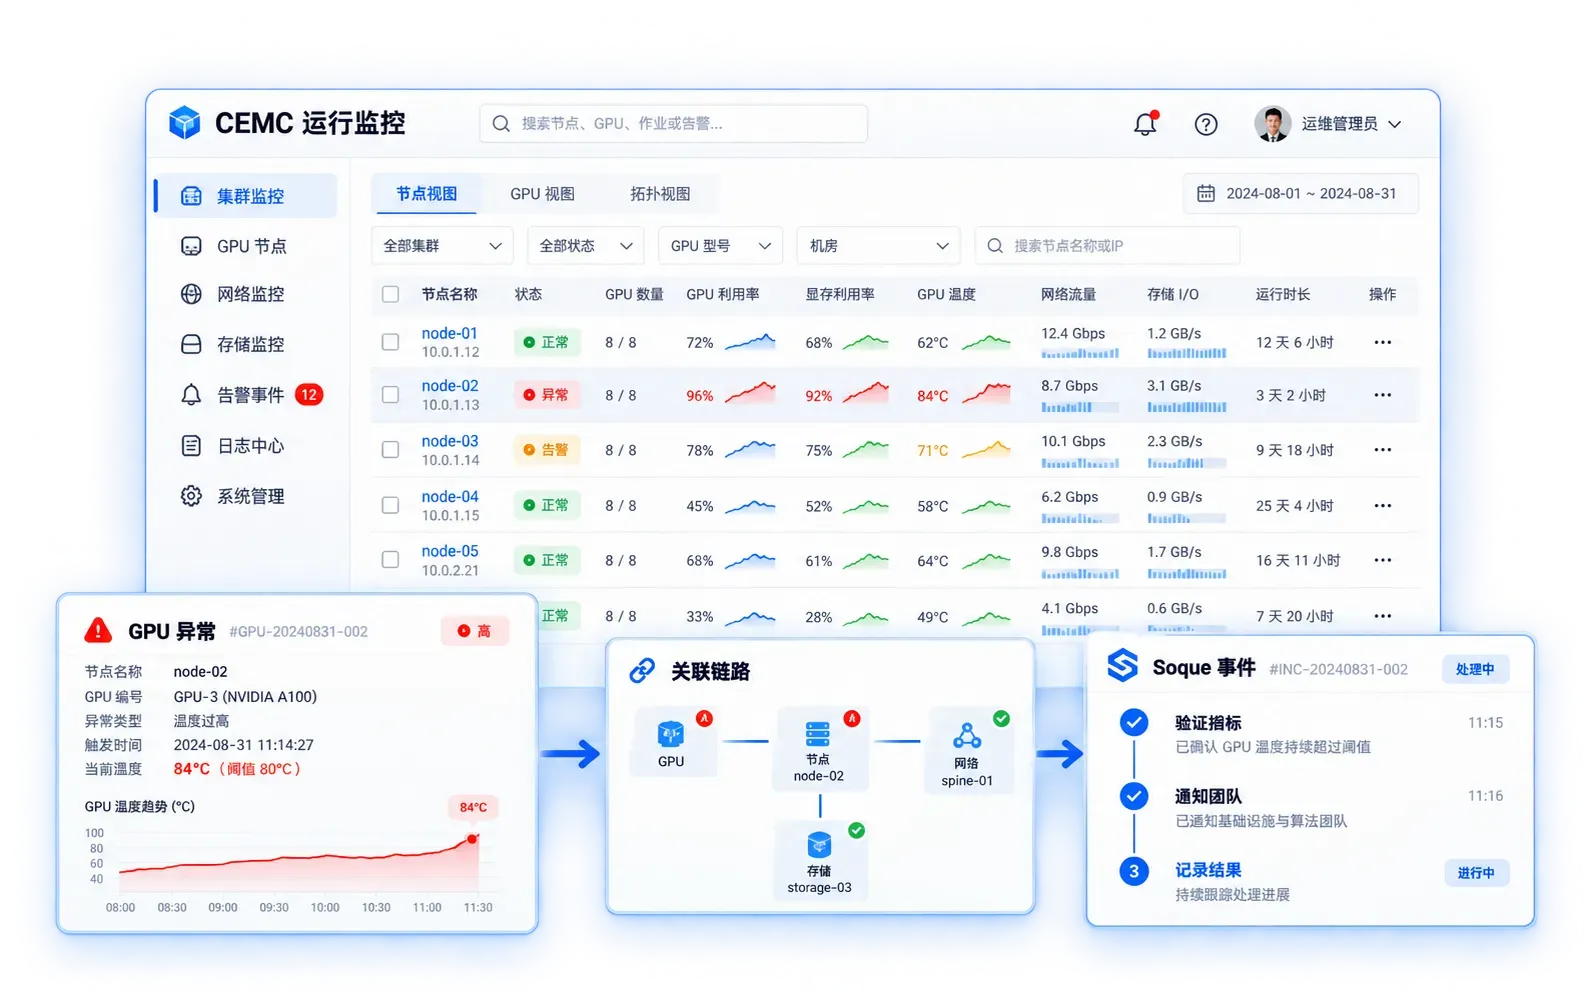
当节点温度异常、网络错误或存储访问延迟出现时,将指标、拓扑与告警放在关联对象中查看,帮助工程师缩小排查范围并组织处理。
应用场景
统一查看 GPU、节点、网络、存储和平台依赖的运行情况,通过告警与巡检识别需要关注的对象,减少逐个系统查看的工作量。
方案价值
集中查看计算、网络、存储与平台依赖,减少运行状态分散造成的信息缺口。
关注温度、容量、链路质量和性能变化,通过告警与巡检发现异常。
结合指标趋势与资源关系缩小检查范围,为跨专业排查提供具体线索。
通过容量、性能与可用性记录识别维护重点,为资源规划提供依据。